Servizio sociale e intelligenza artificiale: la lezione che nessuno racconta
Ad Atripalda, in Irpinia, un consorzio che riunisce 28 Comuni ha firmato la prima partnership italiana con Beam, azienda che fornisce strumenti di intelligenza artificiale generativa già adottati da oltre 140 enti pubblici tra Europa, Regno Unito e Stati Uniti. L’obiettivo dichiarato dal direttore generale del Consorzio Servizi Sociali Ambito A5, Carmine De Blasio, è alleggerire il carico amministrativo degli assistenti sociali, restituire tempo alla relazione con le famiglie e migliorare la qualità delle note di caso. Il progetto ha avuto risonanza internazionale: a inizio 2026 è stato l’unico caso europeo selezionato per una presentazione alla conferenza APISWEA di Macao, dedicata all’impatto dell’IA sul lavoro sociale nell’area Asia-Pacifico.
È una buona notizia, e merita di essere raccontata come tale. Ma il servizio sociale italiano sta attraversando un momento in cui l’entusiasmo per l’efficienza rischia di nascondere una domanda più scomoda: quando un algoritmo entra nella valutazione di una famiglia in difficoltà, chi decide davvero, e sulla base di cosa?
Allegheny, il caso che tutti citano male
Per rispondere, vale la pena guardare al caso più studiato al mondo in questo campo: l’Allegheny Family Screening Tool, attivo dal 2016 nella contea di Allegheny, in Pennsylvania. L’algoritmo analizza oltre cento variabili (storia familiare, dati giudiziari, accesso ai servizi sociali e sanitari) e calcola un punteggio di rischio da 1 a 20 per ogni segnalazione di possibile maltrattamento infantile. Un punteggio alto non apre automaticamente un caso: l’assistente sociale lo riceve come un’informazione aggiuntiva, da integrare con il proprio giudizio professionale, prima di decidere se avviare un’indagine.
Una valutazione indipendente condotta dall’università di Stanford nel 2019 ha trovato che l’introduzione dello strumento ha migliorato l’accuratezza delle decisioni di screening e si è accompagnata a una riduzione contenuta delle disparità razziali nell’apertura dei casi. È il dato che viene citato più spesso, e che ha reso Allegheny un modello di riferimento internazionale.
C’è però un secondo dato, meno citato, che racconta una storia più interessante. Un’indagine della Carnegie Mellon University, ottenuta in esclusiva dall’Associated Press, ha calcolato che se gli operatori avessero seguito alla lettera le indicazioni dell’algoritmo per ogni segnalazione tra agosto 2016 e maggio 2018, il tasso di disparità tra famiglie nere e bianche nell’apertura dei casi sarebbe stato del 20%. Nella realtà, quel tasso si è fermato al 9%, perché gli assistenti sociali hanno seguito il proprio giudizio invece dell’algoritmo in circa un caso su tre.
In altre parole: l’algoritmo, lasciato decidere da solo, avrebbe prodotto più del doppio della discriminazione che ha effettivamente avuto luogo. È stato il dissenso professionale, sistematico e numericamente significativo, a correggere lo strumento, non il contrario. Questo capovolge la narrazione più diffusa, secondo cui l’intelligenza artificiale arriva a correggere i pregiudizi degli esseri umani. Ad Allegheny è successo l’opposto: il giudizio umano ha corretto i pregiudizi nascosti nei dati su cui l’algoritmo era stato addestrato.
Quando manca la possibilità di dissentire: il caso olandese
Per capire perché questo dettaglio sia decisivo, basta guardare a cosa succede quando quella possibilità di dissenso viene meno. Nei Paesi Bassi, tra il 2013 e il 2019, l’amministrazione fiscale ha utilizzato un sistema algoritmico, noto come SyRI, per individuare frodi nei sussidi destinati alle famiglie con figli. Il modello assegnava un punteggio di rischio più alto a chi non aveva la nazionalità olandese o aveva un doppio passaporto, trattando l’origine straniera come un indicatore di possibile frode.
Circa 20.000 famiglie, in gran parte di origine migrante, sono state accusate ingiustamente e costrette a restituire sussidi già percepiti, in alcuni casi per decine di migliaia di euro. Le conseguenze sono state pesanti: debiti, povertà, separazioni familiari. Nel maggio 2022 il governo olandese ha riconosciuto pubblicamente che la causa profonda dello scandalo era il razzismo istituzionale incorporato nei criteri dell’algoritmo. Il governo guidato da Mark Rutte si era già dimesso nel gennaio 2021 per questa vicenda.
Tecnicamente, SyRI e l’Allegheny Family Screening Tool fanno la stessa cosa: trasformano dati personali in un punteggio di rischio. La differenza che ha prodotto due epiloghi opposti non sta nel codice. Sta nel fatto che ad Allegheny l’operatore manteneva potere decisionale reale e visibile, mentre nel sistema olandese il punteggio algoritmico orientava in modo quasi automatico l’azione amministrativa, senza un contraddittorio effettivo e senza che i cittadini potessero conoscere né contestare i criteri usati per valutarli.
La burocrazia che si può alleggerire, e quella che non si può delegare
Questa distinzione, tra strumento che supporta e strumento che sostituisce, è il punto su cui si gioca oggi l’adozione dell’intelligenza artificiale nei servizi sociali italiani. Walter Tripi, AI Manager e formatore che lavora con enti e organizzazioni su un uso consapevole di questi strumenti, individua una linea di confine utile per orientarsi: esiste una burocrazia strumentale, fatta di scadenze, moduli e verbali, che può essere automatizzata senza danno, perché richiede accuratezza più che giudizio. Ed esiste una burocrazia valutativa, intrecciata a decisioni che riguardano la vita delle persone, dove la valutazione professionale non è una procedura da velocizzare ma un atto di competenza, esperienza e lettura del contesto.
Il rischio concreto, quando l’introduzione dell’IA in un servizio pubblico non è accompagnata da una riflessione esplicita su questa distinzione, è uno scivolamento progressivo: si comincia automatizzando i verbali, e gradualmente, senza che nessuno lo decida formalmente, finiscono per essere delegati anche elementi della valutazione. Non per una scelta deliberata, ma per inerzia organizzativa e per la pressione di un carico di lavoro che raramente si allevia del tutto.
Tre domande operative, non tre principi astratti
Tradotta in pratica quotidiana, la cautela necessaria si articola in poche domande verificabili.
La prima riguarda la riservatezza dei dati. Quando un operatore usa una piattaforma di intelligenza artificiale generativa per redigere una relazione su una famiglia, è necessario sapere su quali server quei dati vengono elaborati, chi può accedervi e per quanto tempo restano conservati. Non è un dettaglio tecnico secondario: una persona in condizione di vulnerabilità ha il diritto di sapere che la propria storia, raccontata in un momento di fragilità, non sta circolando su sistemi fuori da ogni controllo.
La seconda riguarda i limiti della traduzione in punteggio. Una famiglia non è una somma di variabili: è una storia fatta di contesto e sfumature che non sempre si lasciano misurare. Gli strumenti di analisi dei dati restano utili, ma solo se chi li usa ricorda che il punteggio è un’approssimazione utile alla decisione, non un giudizio sulla persona.
La terza riguarda il consenso informato, soprattutto quando si introducono strumenti di trascrizione automatica dei colloqui. Un colloquio di servizio sociale è spesso l’unico spazio in cui una persona racconta cose che non ha mai detto a nessun altro. Sapere che quella conversazione può essere elaborata da un sistema automatico cambia, almeno potenzialmente, la natura di quello spazio: non significa che la trascrizione sia sbagliata in sé, significa che richiede un’autorizzazione esplicita e comprensibile, non una clausola generica firmata in fondo a un modulo.
La variabile che fa davvero la differenza
Se si dovesse isolare un solo fattore che distingue le sperimentazioni che funzionano da quelle che producono danno, non sarebbe la qualità tecnica dello strumento. Sarebbe la formazione delle persone che lo usano, e il margine di autonomia professionale che l’organizzazione è disposta a lasciare loro.
Allegheny ha funzionato, nei limiti che la stessa comunità scientifica continua a discutere e monitorare, perché gli assistenti sociali sono stati messi in condizione di dissentire dall’algoritmo, e lo hanno fatto sistematicamente. Il sistema olandese ha prodotto uno dei più gravi scandali amministrativi della storia recente europea perché quella possibilità di dissenso era, di fatto, assente. La sperimentazione irpina si gioca esattamente su questo crinale: la sua riuscita non si misurerà dal numero di ore amministrative risparmiate, ma da quanto quel tempo restituito si traduce in più ascolto, più verifica critica e più presenza accanto alle famiglie.
Il servizio sociale italiano non ha bisogno di scegliere tra rifiutare l’intelligenza artificiale o adottarla senza riserve. Ha bisogno di una domanda semplice da porre ogni volta che un nuovo strumento entra in un ufficio: questo libera tempo per la relazione, o la sostituisce con un numero? La risposta a quella domanda, non la sofisticazione dell’algoritmo, è ciò che separerà i prossimi casi di successo dai prossimi scandali.
 Installatori fotovoltaico: guida alla scelta dei migliori professionisti per il tuo impianto solare
 Ristrutturazioni chiavi in mano a Pordenone: tra valorizzazione dell’immobile e nuove esigenze abitative
 Dal pavimento alla parete il gres effetto pietra come elemento di continuità progettuale
 Salone parrucchiera e benessere dei capelli, cosa cambia quando il trattamento è davvero personalizzato
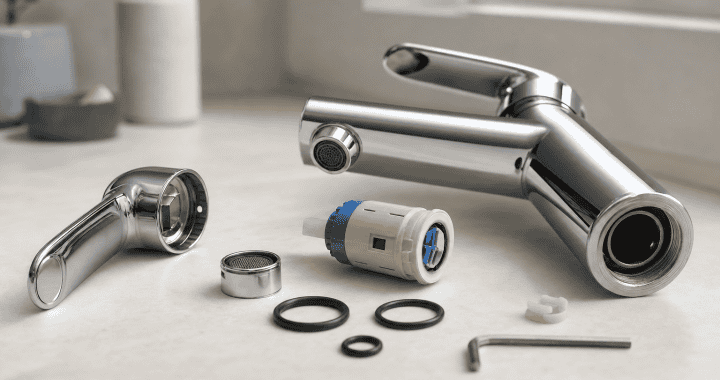 Ricambi Grohe, quali componenti si possono sostituire senza cambiare tutto il rubinetto
 Aspiratore Unghie: La Soluzione Perfetta per Manicure Professionali a Casa
 Fatturazione in cloud: come gestire fatture, pagamenti e scadenze online
 Photobooth: come funziona, quali tipologie esistono e cosa cambia tra foto, stampa e video
 Sanificazione ad ozono tra trattamento degli ambienti, sicurezza e corretta gestione degli spazi